新HPCの歩み(第302回)-2010年(j)-
|
DARPAは、現在のシステムよりエネルギー効率を大幅に改善し、プログラミングが容易な新しいコンピュータアーキテクチャとプログラミングモデルを開発するUHPCプロジェクトを開始し5組織を選んだ。ヨーロッパではPRACEが正式発足するとともに、エクサスケールを目指すEESIが始まった。 |
アメリカ政府の動き
1) 連邦予算削減(科学技術予算削減)
HPCwireによれば、下院共和党は5月18日に法案H.R. 5325を赤字削減のため葬った。この法案は、今後3年間に連邦政府が$40B(約4兆円)を科学技術のために投入するものであった。2007年8月にブッシュ大統領は今後10年間に科学技術予算を倍増しようという「アメリカCOMPETE法案(America COMPETE Act-H.R.2272))」に署名し、2010年にもこれを再確認する法律(HR 5116, The America COMPETES Reauthorization Act of 2010)ができたはずであるが、民主党が絶対多数を持っていないため、妥協を余儀なくされたようである。America COMPETE Actは、NSF, DOE, NIST, NOA, NASAなどに多額(2008年度予算で$33.6B)の予算を与えるもので、high-risk, high-return の研究を狙っていた。もちろんAmerica COMPETE Actが完全に予算化されたことはなかったが、それでもこれまで政府も議会も科学には配慮をしてきていた。委員会レベルでは超党派的な支持があったが、共和党は何重もの修正案を出してこれを葬ろうとしていた。これ以上修正を出させない措置のためには2/3の多数が必要であったが、民主党は計算違いをして、共和党から15票を得たにも関わらず、261対148で、2/3には12票足りなかった。(HPCwire 2010/5/20)
本当はH.R. 5325は妥協の産物であり、元のH.R. 5116法案では、3年間に$47Bではなく、5年間に$85Bを出すことになっていた。さらにこの法案は、「COMPETE予算は、仕事中にポルノを見ていると確認された連邦職員のサラリーには使ってはいけない」などと決められていた(何ですかね?)。それにも関わらず保守派の共和党員はこの法案をつぶそうとしていた。スーパーコンピュータ予算にはどう響くか?(CBS News 2010/5/19)
2) アメリカのExascale計画
エクサスケールを目指す次世代ソフトウェアの開発のために2009年に始まったIESP (International Exascale Software Project)は、2010年にも活動が続けられた(国際会議の項を参照)。
2010年8月6日、DARPA (Defense Advanced Research Projects Agency)はUHPC (Ubiquitous High Performace Computing)プログラムを開始し、実行主体として5組織を公式に発表した。Intel, NVIDIA, MIT, SNLとGeorgia Tech(評価)である。UHPC プログラム の目標は、現在のシステムよりエネルギー効率を大幅に改善し、プログラミングが容易な新しいコンピュータアーキテクチャとプログラミングモデルを開発することである。UHPCで開発するシステムの性能目標は、Linpackベンチマークで1 PFlops、電力効率目標は、50 GFlops/Wである。電力効率目標 は、Top500、Green500リスト(2010年6月時点)で1位のシステムと比較すると、それぞれ約200 倍、65倍の改善に相当する。プロトタイプは2018年までに完成する予定である。(HPCwire 2010/8/10)
DARPAはこれを補完する形で、6月からOHPC(Omnipresent High Performance Computing)プログラムを立ち上げ、UHPCの5組織にとらわれずに、広くエクサスケールのための基礎的な新技術の開発を目指していた。とくに、メモリの削減技術、並列化プログラミングの抽象化、障害管理とエラー回復の自動化などを研究する予定であった。しかし契約直後キャンセルされたようである(要確認)。(EDN 2012/2/23) UHPCプログラムもPhase 1以降への展開が困難視されている。
3) NSF(2010年度予算)
NSFは2010会計年度(2009年10月~2010年9月)の予算として、$7.045Bを要求した。これは、2009年度より$555M (8.5%)増加している。(FY 2010 Budget Request to Congress) NSF関連の予算は2009年12月9日に$6.926Bと決定した。2009年度より$436M (6.7%)の増額である。(Fiscal Year 2010 Appropriation)
4) PSC (Blacklight)
PSC (Pittsburgh Supercomputing Centerは、NSFから$2.8Mの予算を得て、2010年にSGI Altix UV1000(愛称Blacklight)をTeraGrid用に設置した。512基のeight-core プロセッサ(全4096コア)が、32TBのメモリを共有する。2011年初めから運用を開始した。(CMU Community News 2011/4/11)
ヨーロッパの動き
 |
|
1) ヨーロッパ連合(PRACE)
ヨーロッパのPRACE (the Partnership for Advanced Computing in Europe)は、2010年4月23日に正式発足した。本部はベルギーのBrusselsに置かれ、ベルギー法上の国際NPO (association internationale sans but lucrative - aisbl)である。2004年からEUの支援により準備が進められ、2008年に準備フェーズをスタートさせていた。最初のメンバー国は21か国であったが、2012年には25か国に、2025年には26カ国に増加している。最初のホスト国(HPC資源提供国)は4か国(フランス、ドイツ、イタリア、スペイン)で、2010年から2015年までの第1期の予算€400Mを保証した。2013年初めには、6台のTier-0システムが利用されていた。2016年にはスイスが第5のホスト国として加わり、CSCSの資源の提供を始めた。
PRACEの資源利用にはProject Accessと Preparatory Accessとがある。Project Accessは本格利用で、年2回募集され、PRACEのPeer Review Processにより審査される。課題は、計算機利用の技術面と、科学的意義の両方から審査される。Preparatory Accessは、コード検証や移植のための少量の資源提供であり、「京」や「富岳」のトライアル・ユースや試行課題のようなものであろう。Project Accessの際には、コードが準備できていることを証明する必要がある。
PRACEは2018年段階で、7台の最先端HPCシステムの資源(いわゆるTier-0 systems)を、peer reviewに基づく課題審査により、産学官のユーザに提供している。同時に、ユーザ支援も行い、アプリケーションプログラムの移植、高並列化、最適化を支援している。また、6か所のPRACE Advanced Training Centres (PATC)と、4か所の PRACE Training Centres (PTC)があり、初級から上級までのユーザ育成も行っている。2002年から活動しているDEISA (the Distributed European Infrasturcture for Supercomputing Applications)はTier-1に位置づけられた。
第3期開始時(2020年)でのTier-0システムは下記の通り(PRACE HPC Infrastructure)性能の単位はPFlops。Rpeakは複合システムの総和のこともある。その後のシステム増強もある。
|
国 |
組織 |
システム |
Rmax |
Rpeak |
Top500初出 |
|
フランス |
CEA (GENCI) |
Joliot-Curie KNL |
1.3 |
2.3 |
2018/6 151位 |
|
フランス |
CEA (GENCI) |
Joliot-Curie Rome |
7.0 |
12.0 |
2019/11 59 位 |
|
フランス |
CEA (GENCI) |
Joliot-Curie SKL |
4.1 |
6.6 |
2018/6 34位 |
|
ドイツ |
JUELICH (FZJ) |
JUWELS Booster |
44.1 |
71.0 |
2020/11 7 位 |
|
ドイツ |
JUELICH (FZJ) |
JUWELS Cluster |
6.2 |
9.9 |
2018/6 23位 |
|
ドイツ |
LRZ (GCS) |
SuperMUC-NG |
19.5 |
26.9 |
2018/11 8位 |
|
ドイツ |
HLRS (GCS) |
HAWK |
19.3 |
25.2 |
2020/11 16位 |
|
イタリア |
CINECA (CINECA) |
Marconi100 |
21.6 |
29.4 |
2020/6 9 位 |
|
スペイン |
BSC (BSC) |
MareNostrum 4 |
6.47 |
11.15 |
2017/6 13位 |
|
スイス |
CSCS (ETH) |
Piz Daint |
9.78 |
15.99 |
2016/11 8 位 |
2018年ごろまでは、ヨーロッパでのHPC導入は主にPRACEが主導していた。エクサスケール級のスーパーコンピュータには膨大な資金が必要となったため、より強力な資金調達能力を持つEuroHPC JU (Joint Undertaking)が2018年に設立される。これによりPRACEは、それまでの長年の知識とノウハウを生かし、スーパーコンピュータの課題審査、ユーザ支援、トレーニング、利用促進などを担当するようになっている。
2) ヨーロッパのExascale
ヨーロッパでもExaFlopsに向けての動きが始まっている。EESI (The European Exascale Software Initiative)は、2008年にFP7 (the Seventh Framework Programmes for Research and Techniological Development)により生まれた。ECは2010年6月1日に18か月のプロジェクトEESI1(第1期)として予算化した。7月2日にはEESI Kick off meeting がParisで開催され、2010年11月8日~9日にEESI Initial WorkshopがAmsterdamで開催された。EESIの重要な活動は、グランドチャレンジアプリケーションに対応する4つのWGと、エクサフロップを実現するコンピュータ技術に関する4つのWGである。各WGは約15名の専門家から構成され、キーとなる科学的・技術的チャレンジを明らかにすることを目指している。特にヨーロッパの強さと弱さ、ヨーロッパにおける現在の協力関係、現在のプロジェクトの分析も行う。(HPCwireの2011年1月6日号掲載のJean-Yves Berthou氏とのインタビューから)
EESI1としては、2011年10月10日~11日にBarcelonaでFinal Conrerenceを開催した。第2期となるEESI2は2012年9月1日~2015年6月30日まで。
3) Jülichスーパーコンピュータセンター
FZJ (Forschungszentrum Jülich)にあるJSC (Jülich Supercomputer Centre)は、2010年3月23日、IBM社と協定を結び、共同でExascale Innovation Centerを運営し、エクサスケールのスーパーコンピュータのためのハードウェアおよびソフトウェアについて研究開発を進めると発表した。IBM BöblingenとJSCから5人ずつ人を出し、アメリカのYorktown HeightsのWatson研究所と協力して、2015年にはプロトタイプを、2019年に本物を製作する予定とのことである。(JSC News April 2010) (HPCwire 2010/3/23)
4) LRZ (Leibniz Rechenzentrum)
PRACEの発表によると、München近郊のGarchingにあるLRZは、2010年12月15日、2012年までにピーク2 PFlopsのマシンSuperMUCをIBMによって建設するとのことである。相互接続網はFDR Infinibandで、冷却はHot Water Coolingである。これは1 PFlopsの”JUGENE” (Jülich Blue Gene/P)や、フランスCEAの1.25 PFLopsのCurieに続くTier-0スーパーコンピュータとなる。SuperMUCはBlueGeneではなく、Powerでもなく、次世代のXeonプロセッサ(おそらくSandy Bridge)を使用する。
Hot water cooling(温水冷却)は、半導体を高温(90℃程度)で動作させ、チラーを用いず、クーリングタワーで直接放熱させる方式で、サーバなどでは前から用いられていた。HPCではBlueGene/Qでも用いている。接合温度が高いためのリークの増大や速度の低下と、チラーの電力との競争になり、寒いところでは有利である。(HPCwire 2010/12/15)
5) クロアチア
2010年、Rijeka(リエカ)大学内に、Center for Advanced Computing and Modelling (CNRM)を発足させ、CPUとGPGPUからなるシステムを設置した。
中国の動き
1) 中国のHPC事情
2010年12月9日~10日に、秋葉原コンベンションホールにおいて第十回PCクラスタシンポジウムが開催されたが、シンポジウムの2日目に、中国科学院スーパーコンピューティングセンターのXuebin Chi博士が「中国のHPC事情」と題して中国のスーパーコンピュータ開発の歴史を語った。「ベストシステムズ・メールマガジン」12月15日(第151号)に内容が紹介されている。
1990年代から6つの研究機関(国立スーパーコンピュータセンター「北京」「武漢」「成都」「合肥」、および「中国科学院」、「上海センター」)で行われ、メーカーとしてはLenovo(聯想)とDawning(曙光)である。Lenovoは2008年にDeepComp700で150 TFlopsを達成し、Dawningも2009年には200 TFlopsを達成しTop500の10位にランクされた。Chi博士によると、6月のTop500で2位となったNebulae (Dawing TC3600)は600 TFlopsのCPU (Xeon X5650, 6C)と3 PFlopsのGPU (NVIDIA 2050)で構成され、費用は75億円、12月のTop500で1位となったTianhe-1Aは、1 PFlopsのCPU (Xeon X5670, 6C)と4 PFlopsのGPU (NVIDIA)で構成され、やはり75億円とのことで、いくら中国でも安すぎるのでは、という印象であった。隠れた費用(設備、人件費、電気など)があるのかもしれない。将来計画として、中国科学院は、2015年には10 PFlops(ピーク?)のマシンを88億円で建設するほか、他機関でもPFlops級のマシンを開発する計画とのことである。2020年までにはExaを目指すのであろうか。当時は、中国の事情を聴くチャンスがあまりなかったので、刺激的な講演であった。
2) 中国科学院(龍芯3号)
中国科学院の胡偉武(Weiwu Hu)が、2001年から開発しているMIPSベースのマイクロプロセッサ「龍芯(Loongson)」は、2001年8月に(一説には2002年)龍芯1が、2003年10月に龍芯2号を発表し、龍芯2号の改良版である龍芯2Cや龍芯2Eや龍芯2Fも発表した。
中国科学院計算技術研究所は2009年9月、64ビット4コア高性能汎用プロセッサ龍芯3Aの開発に成功した。65 nmプロセスを用いた。(MIT Technology Review 2010/1/19) (ASCII.jp 2010/1/8)
2010年4月22日の人民網日本語版によると、中国科学技術大学と深圳大学は、龍芯3Aおよびその他の国産部品・設備・技術を用いて、スーパーコンピュータ「KD-60」の開発に成功し、2010年4月17日に専門家の検査に合格したとのことである。KD-60は80個以上の龍芯3Aを搭載し、1 TFlopsのピーク性能を持つ。これは中国科学技術大学が2007年末に龍芯2Fを搭載したスパコン「KD-50-I」を開発した(新HPCの歩み(第254回)-2007年(g)-参照)のに続くものである。(人民網日本語版 2010/4/22)(Science Portal China 2010/4/22)(朝日新聞 2010/4/22)(深圳大学News 2010/4/22)(Shanghai Daily 2010/4/23) Kは「科学kexue」、Dは「大学daxue」であろう。
2009年のところに書いたように、曙光6000に8000超の龍芯3号を載せると胡偉武が語ったとの話もあったが、これは実現しなかった。かつて、曙光5000Aにも龍芯を載せるという計画があった(新HPCの歩み(第234回)-2005年(l)-)が、結局AMDのOpteronを採用した(上海のMagic Cube)。
2010年8月のHot Chips会議で、龍芯3Bの詳細が発表された。8コアの64-bitチップで、65 nmテクノロジで製造する。クロックは1 GHz。SIMDは256ビットで、クロック当たり64 bitの乗加算を8個実行できる。Nebulaeの次のシステムはさらに次の龍芯3Cを用い、28 nmテクノロジで16コアのチップとのことである。(HPCwire 2010/8/26)
龍芯プロセッサは、核高基(hugaoji)という国家プロジェクトの成果の一つである。
3) 中国科学院(分散スーパーコンピュータ)
新華網によると、中国科学院では、2010年4月24日、GPUを搭載した100 TFlops級のスーパーコンピュータ10台を、聯想(Lenovo)社 と曙光社が協力して各分野の研究所に設置した。これらはネットワークで接続され、全体として倍精度で1 PFlops、単精度で3 PFlopsのピーク性能である。Top500には登場せず、詳細は不明である。(Science Portal China 2010/4/26)
4) 申威ShenWei SW-3
中国南部江蘇省の無錫市にある江南計算技術研究所は、2010年、申威ShenWei SW-3プロセッサを開発した。SW1600とも言い、65 nmプロセスで製造され、16コアの64-bit RISCである。独自の命令体系ということになっているが、Alpha 21164に基づいていると推測されている。クロックごとにFMAを4命令実行できる。975~1200 MHzで動作し、1100 MHzではチップ全体で140.8 GFlopsのピーク性能を持つ。これを用いて、2011年、ピーク1 PFlopsの神威藍光(Sunway Blue Light)が構築された。
江南計算技術研究所は1951年創立で、正式には中国人民解放軍 戦略支援部隊 網絡系統部第五十六研究所というらしい。2006年には申威(ShenWei, Sunway) SW-1プロセッサを、2008年には第2世代の申威(ShenWei, Sunway) SW-2プロセッサを開発した。SW-3は第3世代である。
5) 新岸線公司(ARMプロセッサ)
科技日報によると、2004年に創立された中国チップメーカー新岸線公司(Nufront、北京)は、2010年9月14日北京で、英国ARM社とともに、NuSmart2816と名付けられたプロセッサを発表した。ARM社のCortex-A9アーキテクチャに基づき、中国が独自に設計したdual coreプロセッサである。チップの消費電力は2 Wで、新型のネットブックやタブレットパソコン、スマートテレビなどの新製品だけでなく、デスクトップやノートパソコンにも使われると期待している。(Science Portal China 2010/9/15)
6) 曙光(Sugon)
曙光公司が2010年4月8日に明らかにしたところによると、2008年に発売された、中国初となる100 TFlopsのスーパーコンピュータ曙光5000は これまでに431台売り出されたという。曙光5000の発売により、中国は米国に次いで2番目に100 TFlops以上のスーパーコンピュータを製造・応用できる国となった。曙光公司の歴軍総裁によると、現在すでに431台の「曙光5000」が発売され、上海、成都、甘粛など、さまざまな省・市で使われているという。うち、最も影響力があるのが、上海スーパーコンピュータセンターに2008年に設置された曙光5000A (Magic Cube)である。2010年5月現在、利用率は70%に達しているとのことである。(Science Portal China 2010/4/9)(Science Portal China 2010/5/4)
曙光公司が2010年5月27日に明らかにしたところによると、同社の天津産業基地では、1 PFlopsを越える中国初のスーパーコンピュータ「星雲」の開発に成功したとのことである。このスーパーコンピュータは、今年末に深圳スーパーコンピュータセンターに引き渡される。CPUはIntel Hexa Core X5650、GPUはNvidia Tesla C2050 GPUで、相互接続はQDR Infinibandである。ピーク性能は3 PFlops弱、Linpack性能は1 PFlopsを越える。(Scienc Portal China 2010/5/28)
レコードチャイナによると、2010年9月2日、天津曙光計算機産業有限公司副総裁の裘效柯氏は、同社の第2期工場が完成して生産を始め、アジア最大のスーパーコンピュータ生産基地となったことを明らかにした。新たに建設された工場は、敷地面積40000m2、建物面積は20000m2で、年間設計生産能力はPCサーバ50万台とHRCサーバ2000セットという。(Record China 2010/9/3)
2010年4月24日の新華網によると、聯想(レノボ)社 と曙光社は協力して中国科学院の各分野の研究所に演算速度100 TFlopsのスパコン10台を設置し、合計演算速度が6 PFlops近い(単精度?)GPU搭載の分散スパコンシステムを構築したとのことである。中国政府はトップだけではなく、いわば第二階層のスーパーコンピュータの設置にも予算を投入しているようである。
7) 天河一号
2010年1月13日、天津濱海新区の天津スーパーコンピュータ・センター(国家超級計算天津中心)は天河一号の小型版(1/16)を設置し、重点ユーザによる試験運用を開始した。2009年のところに書いたように、2010年10月には天河1Aへの改造が終わっているのが、それとの関係は不明である。(済龍 2010/1/14)(新華網 2010/1/15)(Science Portal China 2010/1/11) (Science Portal China 2010/1/14)
2010年8月5日の新華網によると、「天河1号のキャビネットなど主要設備が天津濱海新区に搬送され、システムの組立てに入った。今月末には組立てを終える。」とのことである。(Science Portal China) 組み立ては9月1日に完了したと発表された。(Science Portal China 2010/9/3) これは実は天河1Aのことではないかと思われる。この推測が正しいとすると、天河一号がフルに天津スーパーコンピュータセンターに設置されたことはないことになる。2009年のところで書いたように、もしかしたら、1月に1/16のシステムが設置されたというのも、NVIDIAに置き換えた1Aのプロトタイプだったのかもしれない。
天河1号は、AMD社のGPUにより2009年11月のTop500で5位を占め、GPUを用いたマシンとしてはトップに立ったわけで、これに対抗心を燃やしたNVIDIA社はかなりの好条件でTesla GPUを提供したようである。その後、天河1Aがトップを取ったとき、NVIDIA社はアメリカ政府に呼び出されて警告を受けたと言われている。いずれも噂であるが、2015年4月にアメリカ商務省が公表する、中国の国防関係の組織への高性能プロセッサの輸出禁止に連なる動きと思われる。
8) 天河1A
2010年10月27日、北京で開催中のHPC China conferenceにおいて、中国Top100の発表の中で、天津スーパーコンピュータセンターは、天河1AがLinpackで2.507 PFlopsの性能を出したと発表した。この時点で世界一である。(Science Portal China 2010/11/1)
2010年11月17日に発表されたTop500において、天河1A号は、1位にランクされた。CPUはXeon 5670 (6C, 2.93 GHz)を14336個、NVIDIA Tesla M2050 GPU 7168個と、8コアの中国製プロセッサFT-1000(飛騰Feiteng)をサービスプロセッサとして組み込んでいる。コア数186368、Rmax=2.566 TFlops、Rpeak=4701.0 TFlopsである。このYinHe FeiTeng(銀河飛騰)という中国チップは、Sparc系のようである。
中国は、CPU総数の1/7は国産チップだと宣伝していたが、演算速度には直接寄与していない。(Science Portal Chian 2010/4/8) (Science Portal China 2010/11/18)国防科技大学計算機学院「天河1号」工程弁公室の李楠主任は、「すべてのCPUを我々の開発したCPUと交換することも可能だ。しかし現在はアプリケーションソフトの発展が追いつかないため、少しずつ交換していく必要がある。個々の性能で見れば、我々のCPUは世界最先端レベルにはまだ劣るが、現在開発中の次世代CPUでは、世界最先端を目指している」と述べた。(Science Portal China 2010/11/18) (InsideHPC 2010/10/27)(日本経済新聞 2010/10/29)(HPCwire 2010/10/28) (CNET Japan 2010/10/29)(日経IT 2010/10/29)
New York TimesはAchlee Vance署名の記事で“China Wrests Supercomputer Title From U.S.”(中国はアメリカからスーパーコンピュータのタイトルをもぎ取った)という表題の記事を載せ、2002年に地球シミュレータがトップに躍り出た事件との対比で論じている。(New York Times 2010/10/28) ただ、Topというなら、地球シミュレータ以前に、NWTが4回ほど、東大のSR2201、筑波大のcp-pacsが各1回と珍しくもないのだが、忘れているようである。(産経新聞 2010/10/29)
別のメディア(Wall Street Journal日本語版 2010/10/29)は、これを製造したのがNUDT(中国人民解放軍国防科学技術大学)であることに注目している。LBNLのHorst Simon副所長は、「中国の新スパコン生産の方が地球シミュレータよりはるかに重要だ」とコメントしているが、これは天河1Aが、オープンな素子を用いており、ガラバゴスではないということであろうか。NVIDIAの社長兼CEO、黃仁勳(Jen-Hsun Huang)氏は、発表の中で「GPUは、HPCの定義をくつがえしている。Tianhe-1Aの登場により、GPUは現在、今日のスパコンのトップ3の2つに採用されていることになる。GPUスーパーコンピュータは、研究と発見の速度を速めたいと考える科学者にとって欠かせないツールだ」とコメントしている。読売新聞は、「蓮舫さん、2位じゃだめです…中国スパコン1位」という記事を載せた。(讀賣新聞 2022/11/14)
天河1Aも、FT-1000プロセッサ、麒麟OSを含め、2006年に国務院が発表した「国家中長期科学技術開発計画概要(2006-2020)」に由来する核高基(hugaoji)という国家プロジェクトの成果の一つである。(野村稔 科学技術動向2011/9-10)
9)国立スーパーコンピュータ深圳センター
科学時報によると、中国科学院深圳先進技術研究院は、中国初のPFlops級のスーパーコンピュータ「星雲(Nebulae)」を深圳の国立スーパーコンピュータ・センター(2011年5月設立)に設置すると発表した。中国政府から2億元、深圳市から数億元の投資を受けている。初期投資の総額は12.3億元(訳197億円)である。の今年末から華南地域、香港、マカオをはじめ全中国で計算サービスを提供する。製造は曙光公司(Sugon)の天津産業基地。(Science Portal China 2010/7/21)
「星雲(Nebulae)」は、すでに2010年6月のTop500リストに登場し、コア数120640、Rmax=1271.0 TFlops、Rpeak=2984.3 TFlopsで堂々2位にランクされている。この時点ですでに深圳のセンターにあったのか、まだ工場にあったのかは不明である。
10) 国立スーパーコンピュータ長沙センター
新華網によると、2010年11月28日、国立スーパーコンピュータ長沙センターが湘南大学で設立された。このセンターは科学技術部が認定した情報化建設重大プロジェクトで、総投資額7億2千万元、第1期工事の建設面積は30000m2である。2011年末に完成する予定。完成後、天河一号を設置すると報じられていたが、天河1Aはすでに天津に移設したので、実際はそこで天河二号を開発したようである(後に広州センターに移設)。(Science Portal China 2010/11/29)
11) 上海スーパーコンピュータセンター
2008年11月のTop500において11位にランクされたDawning 5000A(愛称「魔方」 Magic Cube)は、2009円6月に上海スーパーコンピュータセンターに設置された(試験を経て正式に引き渡されたという意味か)。SC10でのATIP 2010 Workshop on HPC in China(後述)での張教授の講演にもあるように、魔方は天文物理、ナノサイエンス,量子化学、MD、CFDなどの分野で順調に利用され、2010年8月11日にセンターが明らかにしたところによると、7月の使用率は83.67%に達したとのことである。中国国内のスーパーコンピュータに対するニーズは急速に拡大している。(Science Portal China 2010/8/12)
12) China HPC Top100
第9回目となるChina HPC Top100 2010が発表された。10位までを記す。性能の単位はTFlopsである。Top500は2010年11月のTop500での順位を示す。コア数やRmaxなど微妙なずれがある。
|
順位 |
Top500 |
設置場所 |
製造 |
機種 |
Cores |
Rmax |
Rpeak |
|
1 |
1 |
国家超級計算天津中心 |
国防科大 |
天河一号A/7168×2 Intel Hexa Core Xeon X5670 2.93GHz + 7168 Nvidia Tesla M2050@1.15GHz+2048 Hex Core FT-1000@1GHz/私有高速网络80Gbps |
202752 |
2507 |
4701 |
|
2 |
3 |
曙光公司 |
曙光 |
曙光星雲/Dawning TC3600 Blade/ |
120640 |
1271 |
2984.3 |
|
3 |
28 |
中国科学院過程工程研究所 |
中科院過程所 |
Mole-8.5 Cluster/320×2 Intel QC Xeon E5520 2.26 Ghz + 320×6 Nvidia Tesla C2050/QDR Infiniband |
33120 |
207.3 |
1138.44 |
|
4 |
35 |
上海超級計算中心 |
曙光 |
魔方/曙光5000A/1920×4 AMD QC Barcelona 1.9GHz/DDR Infiniband/WCCS+Linux |
30720 |
180.6 |
233,472 |
|
5 |
69 |
中国科学院超級計算中心 |
聯想 |
深腾7000/1240×2 Intel Xeon QC E5450 3.0GHz/140×4 Intel Xeon QC X7350 2.93GHz Infiniband 4xDDR |
12160 |
106.5 |
145.293 |
|
6 |
? |
成都超級計算中心(二期) |
曙光 |
曙光星雲/Dawning TC3600 Blade/220x(2 Intel Hexa Core X5650 + 1 NVidia Tesla C2050)/QDR Infiniband |
5720 |
76.35038 |
141.3896 |
|
7 |
? |
中国科学院計算技術研究所 |
曙光 |
生物専用機/Dawning TC3600 Blade/Intel Hexa Core X5650 + NVidia Tesla C2050 GPU/QDR Infiniband |
4160 |
55.52755 |
102.8288 |
|
8 |
156 |
工程公司 |
IBM |
xSeries x3650M2 Cluster/Intel Xeon QC E55xx 2.53 Ghz/Giga-E |
8960 |
51.2 |
90.68 |
|
9 |
174 |
中国電信 |
HP |
Cluster Platform 3000 BL460c G6/Intel Xeon E5540 2.53 GHz/Giga-E |
7848 |
41.88 |
79.42 |
|
10tie |
212tie |
網絡公司 |
IBM |
BladeCenter HS22 Cluster/Intel Xeon QC GT 2.53 GHz/Giga-E |
7168 |
41.27 |
72.54 |
|
10tie |
212tie |
網絡公司 |
IBM |
BladeCenter HS22 Cluster/Intel Xeon QC GT 2.53 GHz/Giga-E |
7168 |
41.27 |
72.54 |
|
10tie1 |
? |
網絡公司 |
IBM |
BladeCenter HS22 Cluster/Intel Xeon QC GT 2.53 GHz/Giga-E |
7168 |
41.27 |
72.54 |
 |
|
天河一号Aが、押しも押されぬTop500のトップに躍り出たことは、前に書いたとおりである。2003年頃は、China HPC 100の70%は外国製であったが、2010年には、中国製が50%になり、しかも、上位10位のうち1位から7位までは中国製である。Linpack性能合計でも、中国製のシステムが81%を占めている。中国のスーパーコンピュータは今後どう発展するのであろうか。(Science Portal China 2010/12/21)
世界の学界の動き
1) Mandelbrot死去
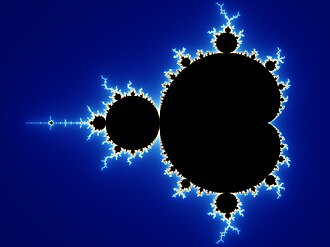
ブノワ・マンデルブロ(Benoît B. Mandelbrot)博士が2010年10月14日に亡くなられた。マンデルブロ集合(図はWikipediaから)が有名であるが、フラクタルの提唱が大きな業績である。2003年にYorke氏と日本国際賞を受賞。ポーランドのユダヤ系の家系に生まれた。(New York Times 2010/10/16)
次回は国際会議(その一)。
 |
 |
 |