

HPCの歩み50年記事一覧
スパコンリスト日本
記事寄稿について
Metaの「Muse」を訓練したギガワット級スーパークラスタ「Prometheus」の内部
オリジナル記事「Inside Prometheus, the Gigawatt Supercluster That Trained Meta’s Muse」
Metaは今週、同社の最新AIモデルファミリー「Muse」のトレーニングに使用した、オハイオ州ニューアルバニーに拠点を置くスーパークラスター「Prometheus」の詳細を公開した。この情報は、コストを一切気にせずにHPCがどのように進化し得るかを垣間見るだけでも、非常に参考になる。
スーパークラスターである「Prometheus」は、大規模なトレーニング作業に対応するために統合された複数の個別クラスタで構成されている。Facebookの親会社であるMetaが10月20日に公開したブログ記事によると、同社はNVIDIAのGrace Blackwellテクノロジーを採用した「Catalina」と「Clemente」という2つのクラスタに加え、NVIDIAのVera Rubinチップを採用した「San Miguel」と呼ばれる第3のプラットフォームを組み合わせた。San Miguelはまもなく稼働を開始する見込みだ。
 |
|
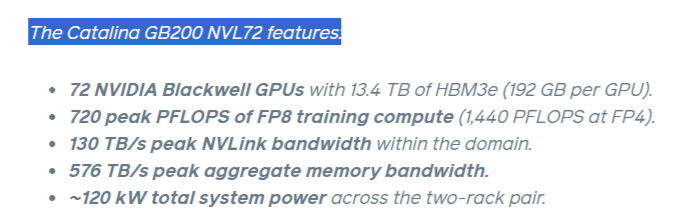
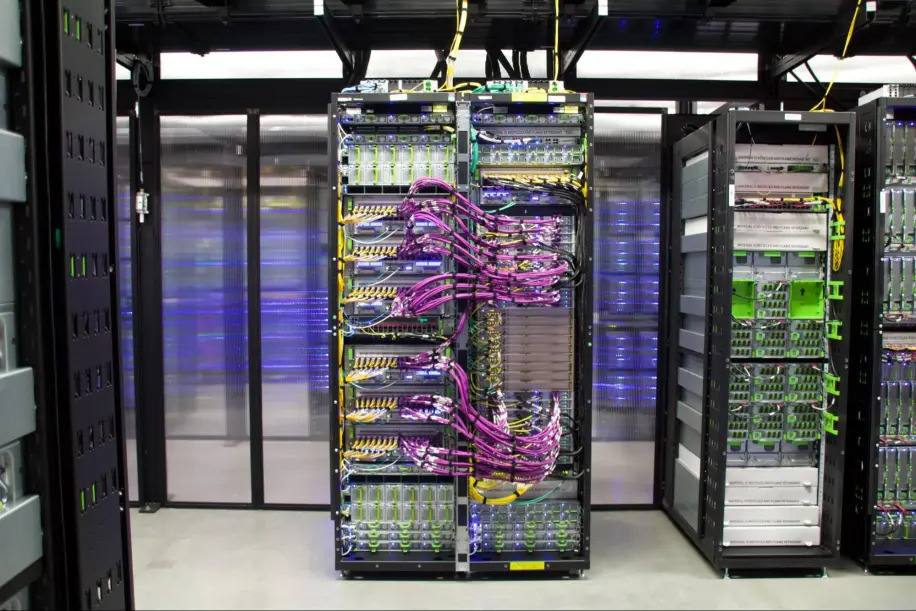
「Catalina」は、NVIDIAのGB200チップとNVL72アーキテクチャを基盤としている。Metaは「Ariel」と呼ばれる独自の2ラック構成を考案し、ラックあたり36個のGPUをNVLink経由で相互接続し、72 GPUからなる統一されたドメインを形成している。
Catalinaにおいて、Grace CPUとBlackwell GPUを内蔵するGB200スーパーチップ1基につき、Metaは2つのConnectX-7 400G NICを採用しており、これによりGPUあたり800GのI/Oを実現している。Metaのエンジニアたちはブログ記事の中で、「業界他社よりも早く」この性能を達成したと述べている。
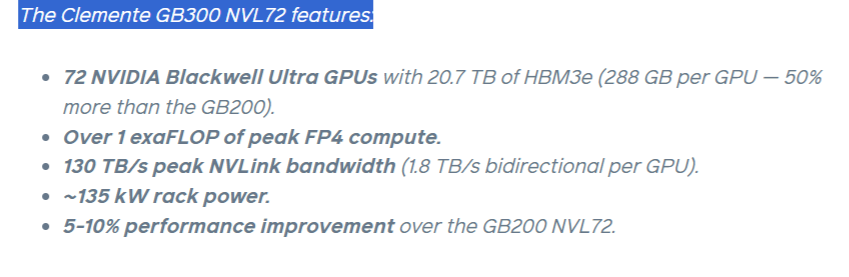
2つ目のクラスタ「Clemente」も、NVL72のスケールアップアーキテクチャをベースとしています。NVIDIAの「Blackwell Ultra」チップであるGB300を採用しており、HBM容量は50%増加し、FP4容量はほぼ同水準を維持しています。
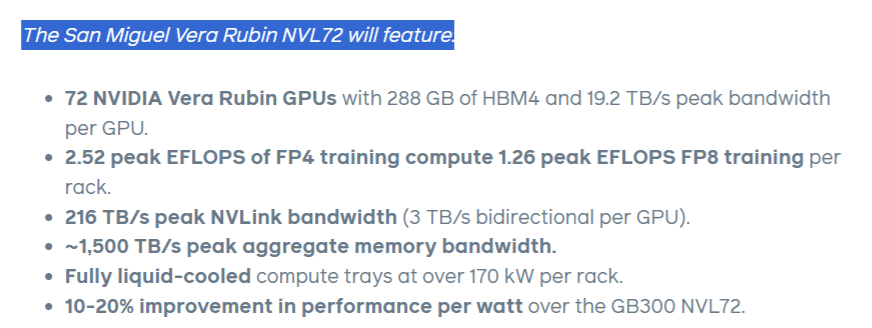
3つ目のクラスタ「San Miguel」は、新しいVera Rubin GPUを採用した「Vera Rubin NVL72」を基盤とする。Metaは、GB300 NVL72と比較して、ワットあたりの性能が10%から20%向上することを期待していると述べている。
 |
|
Metaは、GPU 1基あたりネイティブで800Gの帯域幅を提供するNvidiaのConnectX-8 SuperNICを採用した。これにより、MetaはGPU対CPUの比率を2対1に設定することが可能となり、Catalinaで実施したようにGPUを2つのラックに分割することなく、72基のGPUをすべて収容するためにVera Rubin NVL72ラックをフルに活用できるようになった。
Metaのエンジニアらによると、CatalinaとClementeを接続するイーサネットベースの相互接続は、「高帯域幅・低遅延の多層トポロジーを通じて」最大20,736個のGPUを連結できるという。
ネットワークファブリックの最初のバージョンでは、Disaggregated Scheduled Fabric(DSF)が採用されていた。これは、ファブリック内で「サブパケットレベルのマルチパスルーティングとパケットの再順序付け」に加え、「仮想出力キューおよびクレジットベースのエンドツーエンドフロー制御」を用いて、ネットワークの輻輳を軽減するものである。
 |
|
第2世代では、Non-Scheduled Fabric(NSF)へと移行した。これは、Metaが設計し、Celesticaに製造を委託した第3世代スイッチ「Minipack3」など、動的な負荷分散機能を備えた「シャローバッファ型51.2Tイーサネットスイッチ」を基盤としていた。また、Metaが設計し、Acctonが製造する別のスイッチ「Minipack3N」も採用されている。Minipack3Nは、NvidiaのSpectrum-4スイッチASICをベースにしており、Nvidiaのアダプティブルーティング技術が追加されている。
「DSFもNSFも、MetaのFBOSSネットワーキングスタックに基づいている。これにより、Prometheus内のファブリックを迅速に反復改善・最適化する制御能力と、これらのクラスターを大規模に運用するための可視性が得られる」と、Metaのエンジニアたちは記している。
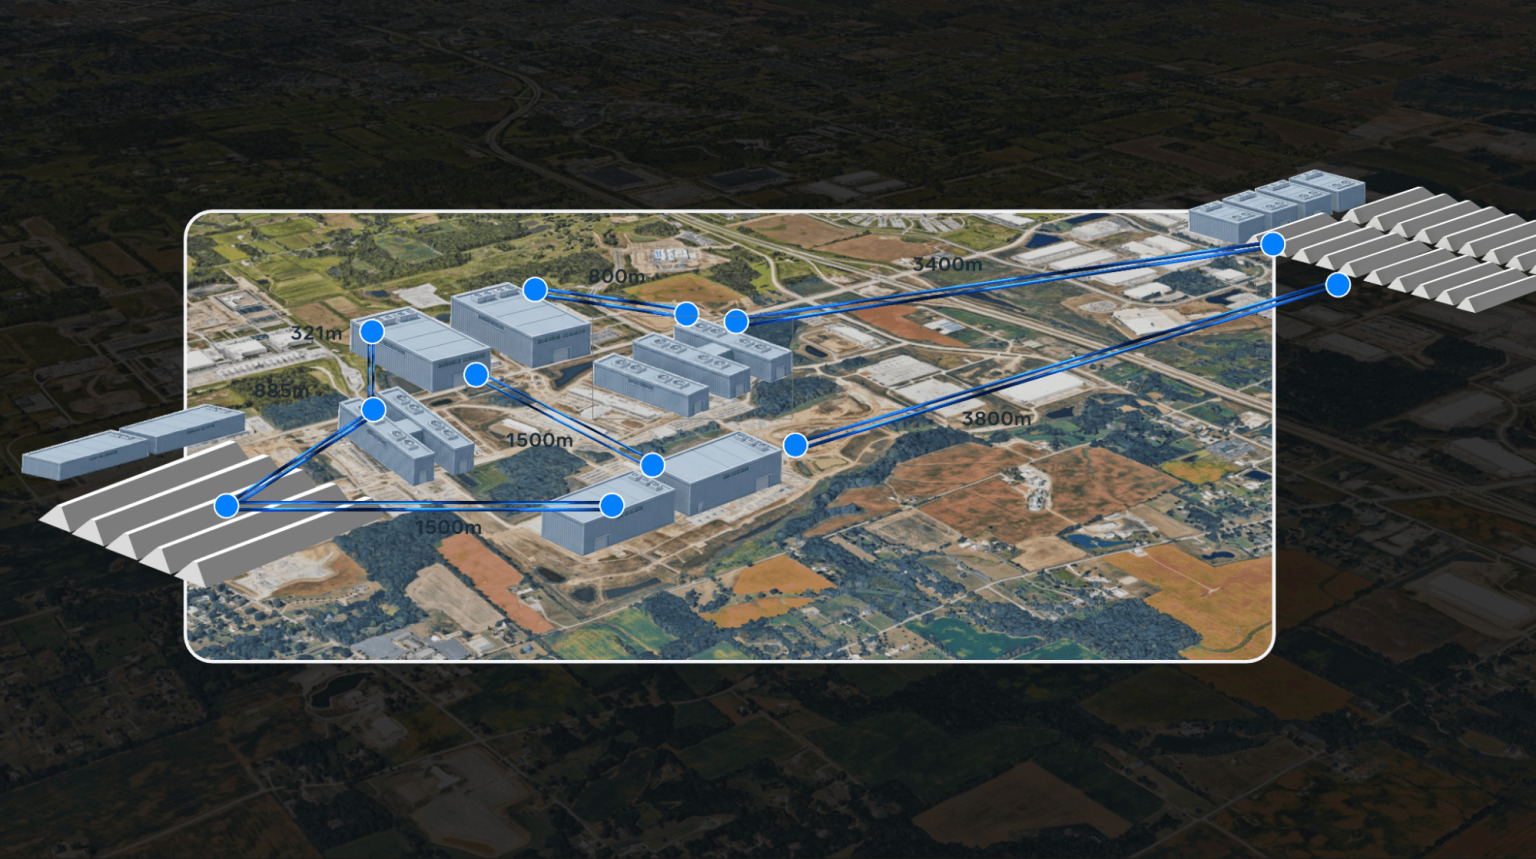
Prometheusは、バックエンドアグリゲーション(BAG)ネットワークも構成要素としている。Metaによると、BAGネットワークは、2キロメートルから100キロメートルの距離に位置するクラスタを接続する多層ハブ・アンド・スポーク型ネットワークに基づいている。BAGネットワークは、Arista 7800シリーズシャーシを用いて構築されており、「大容量バッファを備えたBroadcom Jericho3シリコンを搭載し、リージョンペアごとに数Pbpsの帯域幅を提供している」とMetaは記している。
「このネットワーク上で事前学習を実行するには、特にこれらの距離における光速の制約を考慮し、学習速度が低下しないよう、Meta Superintelligence Labsとの協力による専用の最適化作業が必要だった」と同社は記している。
 |
|
| Metaのバックエンド集約(BAG)は、2kmから100km離れている建物を接続する | |
総じて、Metaのネットワークは数百万マイルの光ファイバー、数万台のスイッチ、そして数百万個の光モジュールで構成されている。
NVL8からNVL72への移行により、Metaはスケールアップクラスタの規模を大幅に拡大し、テンソル並列性を維持しつつ、一度にメモリに保持できるデータ量を増加させることができた。しかし、その一方で、ハードウェア障害の「影響範囲」も9倍に拡大した。
ハードウェア障害への懸念を軽減するため、Metaは各NVL72ドメイン内のGPUのうち8基をオフライン状態に保っている。稼働中の64基のGPUのうち1基が故障した場合、8基のホットスペアのいずれかが即座に稼働を開始し、ジョブは直前のチェックポイントから直ちに再開される。
ラックレベルでも同様の措置を講じており、ラックの2%をホットスペアとしてオフライン状態に保っている。「32,768基のアクティブGPUによるトレーニング実行の場合、これは523台のNVL72ラック、つまり37,656基のGPUをプロビジョニングすることを意味し、アクティブなフットプリントを約13%上回る」と同社は記している。「その余裕の大部分(11%)は、絶対的な信頼性のコストというよりは、72基中64基というスライス構成から生じるものだ。」
チップレベルでの整合性を維持するのは、また全く別の話だ。これは主にNvidiaの領域だが、事態が悪化すればMetaのエンジニアたちの首が飛ぶことになるため、彼らもこのプロジェクトに深く関わっている。
「単一のNVL72ドメインには、200 Gbpsで動作する5,184本の最適化された差動ペア信号リンクが組み込まれており、各リンクはGPU SerDes、コンピューティングトレイのPCB、ケーブルカートリッジ、スイッチトレイのインターフェースなど、複数の潜在的な障害箇所を通過している」とMetaのエンジニアたちは記している。「この高密度ファブリック全体で――レーンあたり200 Gbpsという速度で――一貫した信号の完全性を維持することは、この規模においては前例のない技術的課題である。」
Metaは、Prometheus(およびおそらく他のクラスタ)で使用した2つの障害回復メカニズムを実装した。その中には、障害をデータ並列モデルのレプリカに特定できる場合に作動する「並列処理対応フォールトトレランス(PAFT)」と、特定できない場合に作動する「分散チェックポイント」が含まれる。
 |
|
| San MiguelはVera Rubin NVL72をベースとする | |
Metaは、2025年半ばにPrometheusの導入を開始して以来、その障害発生率を低減させてきた。当時は、8K GPUあたり1日あたり1,000件近くの障害が発生していた。それ以来、中断件数を99%削減し、8K GPUあたり1日2件という目標に近づきつつある。
電力消費の管理は、Metaがいくつかの教訓を得たPrometheusのもう一つの側面だ。単一のジョブによって、電力負荷が突然30%から40%変動し、数十メガワット規模の負荷変動が生じることがある。これに対処するため、Metaは「Dynamo Dimmer」と呼ばれる技術を開発した。これにより、電力上限に近づいた際にGPUの消費電力を徐々に調整し、電力消費を抑制することが可能になった。
CatalinaとClementeの両施設では、水冷方式を採用している。Metaは、ニューアルバニー地域社会で利用可能な水を消費しないよう、ダイレクト・トゥ・チップ方式およびクローズドループ式の水冷を採用している。
特別イベント
International Conference for High Performance Computing, Networking, Storage & Analysis (SC26)
11月 15 - 11月 20
Supercomputing Japan 2027
2027/01/12 - 2027/01/13
寄稿者
 西克也
西克也はフェアチャイルド社、クレイ・リサーチ社、ベストシステムズ社など、30年以上に渡ってHPCに関する仕事に従事している。Hpcwire Japanの編集長として記事の作成と翻訳を行っている。
 小柳義夫
小柳義夫氏は40年以上に亘ってHPCに携わってきた研究者であり、日本のHPC業界における生き字引として有名。現在 高度情報科学技術研究機構に所属し、産業界のHPC推進にあたっている。
 小西史一
小西史一は、理化学研究所、東京工業大学においてHPCおよびバイオインフォマティクスに関する研究と教育に携わってきた研究者。2012年からフォトグラファーとしての活動を開始し、現在はIT技術・セキュリティのコンサルティング業務に携わっている。