

HPCの歩み50年記事一覧
スパコンリスト日本
記事寄稿について
HPCシステムではないが、セレブラス社新型CS-4はAIの怪物だ
オリジナル記事「It’s Not an HPC System, But Cerebras’ New CS-4 Is an AI Monster」
セレブラス社は「Wafer Scale Engine 3」を用いて業界最大かつ最強のチップを開発しており、先日正式に発表した「CS-4」システムでGPUメーカーを圧倒したのも驚くことではない。CS-4はまさにモンスター級の性能を誇り、3つのWSE-3 Turboチップにより、750 PFLOPSのAI演算能力と、毎秒129.6ペタバイトのメモリ帯域幅を実現している。残念ながら、この新しいラックスケールシステムはHPCワークロード向けに設計されたものではないが、だからといってCS-4クラスタがHPCワークロードの隣に設置されることがないというわけではない。
 |
|
| 出典:セレブラス社 | |
今日の生成AIにおいて、計算能力とメモリスループットは重要であり、セレブラス社 CS-4は両方を豊富に提供している。先行するWSE-3チップと同様、各WSE-3Tチップには4兆個のトランジスタ、90万個のAI最適化コア、44GBのSRAMが搭載されている。しかし、セレブラス社はWSE-3Tの性能をさらに引き出し、16ビット演算における計算性能を250 PFLOPSへと倍増させ、メモリ帯域幅も43.2 PBpsへと倍増させた。この「強力なチップ」を3つ組み合わせ(さらに後述するその他の構成要素を加えることで)、CS-4が完成する。
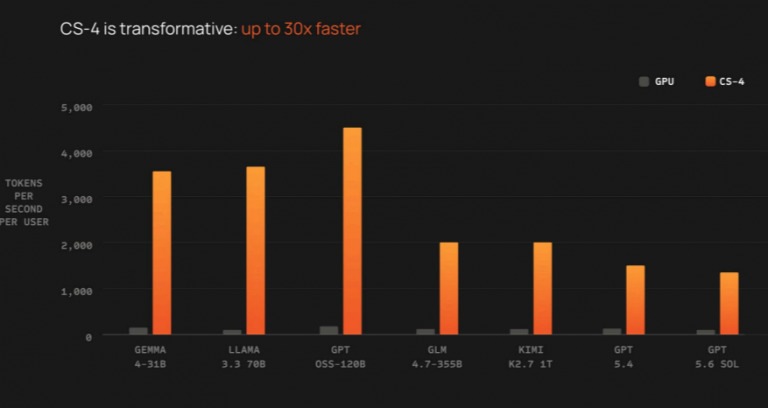
しかし結局のところ、今日の企業が最も重視しているのは、1秒あたりに生成できるAIトークンの数であり、これは内部指標というよりはアプリケーションレベルのベンチマークだ。その点において、CS-4はOpenAIのGPT-OSS-120Bモデルを使用した場合、ユーザ1人あたり1秒あたり4,400トークンを生成する。これは最速のGPUソリューションよりも30倍高速であると、セレブラス社は述べている。
「AIにおいて速度は生産性そのものだ」と、セレブラス社のCEO兼共同創業者であるアンドルー・フェルドマン氏は述べた。従来、これはより小型で性能の低いモデルを使用することを意味していた。しかし、CS-4は最大規模のモデルを実行するように設計されており、10兆パラメータのモデルで毎秒1,000トークンを生成し、さらには最大50兆パラメータを持つ将来のモデルも実行可能だ。
 |
|
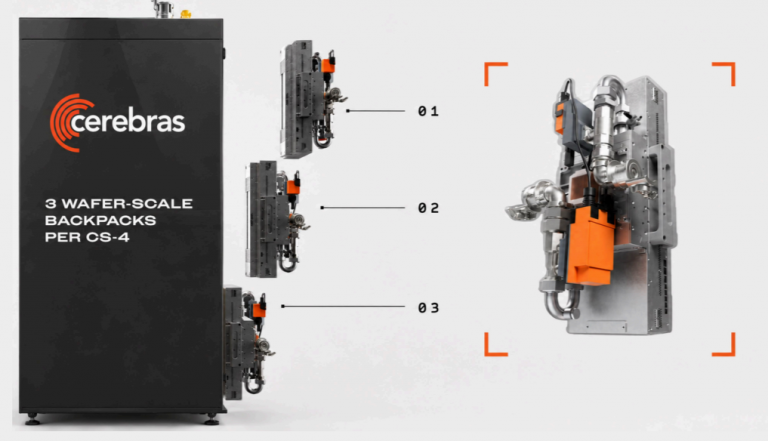
| CS-4には、電源、冷却、I/Oを収容する「バックパック」が搭載されている | |
CS-4は、新しいI/OサブシステムとラックスケールのNexus Platform Architectureを通じて、50兆パラメータのモデルを実行できるようスケールアウトが可能となる。このプラットフォームの一環として、セレブラス社はCS-4に新しいプラグイン式の「コンピュート・バックパック」設計を導入した。
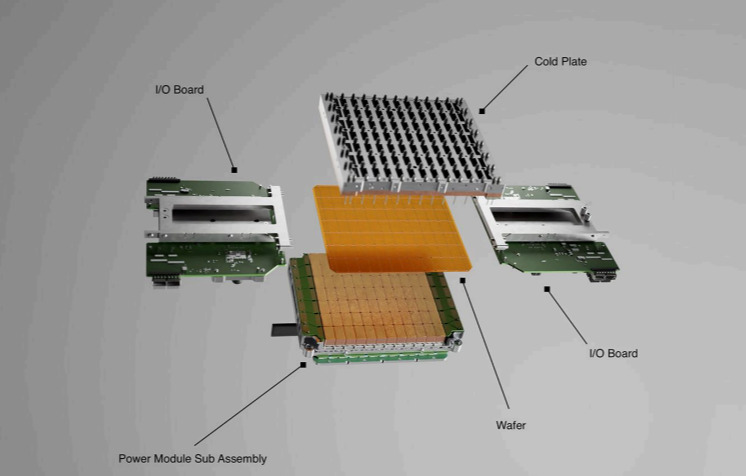
各CS-4バックパックはWSE-3Tチップを中核として構成されており、ハードウェアの稼働に必要な電力変換、液体冷却、高速I/O、および制御電子回路を内蔵している。セレブラス社によると、これらのバックパックはモジュール性と再現性を提供し、パッケージングと製造を簡素化するとのことだ。
また、これらのバックパックには「Wafer I/O Module」と呼ばれる新しいI/Oサブシステムが搭載されている。セレブラス社は、このI/Oサブシステムを用いたシステム接続方法として2つの方式を提供しており、その一つである「Direct Wafer Links」は、スイッチを必要とせずに、遅延2マイクロ秒という低遅延でウェハー間接続を実現する。
また、標準規格に基づくRoCE v2 RDMA接続にも対応しており、他のAIアクセラレータを収容する異種混在データセンターに導入される。セレブラス社によると、CS-4ではオフウェーハの総帯域幅がウェーハあたり2.4テラビット/秒に倍増し、ラックあたりでは7.2テラビット/秒に達するという。
 |
|
| セレブラス社 CS-4 バックパック内部(出典:セレブラス社) | |
また、このバックパックにより、セレブラス社は電力変換を実際のチップにより近い位置で行うことができる。これにより、基板レベルでの電力損失が削減され、WSE-3Tへの電力供給量を2倍に増やすことが可能となり、チップをより高い周波数で動作させることができる(その結果、FLOPSが2倍になる)。
CS-4は最先端のAIモデルの学習および実行を目的に設計されており、セレブラス社が最も強調する性能数値は16ビット精度に基づくものだ。倍精度FP64機能を必要とする多くの従来のHPCワークロードにとっては、これでは不十分だろう。このマシンはそうした用途向けではない。
しかし、CS-4は依然として世界中のスーパーコンピュータセンターで活用される余地がある。高度なコンピューティング分野でAIが導入されるにつれ、最先端のモデルを学習・微調整し、ユーザのために実行するための、より大規模で高速なクラスタの必要性が高まっている。こうしたクラスタは、モデリング・シミュレーションのワークロードを実行する従来のHPC環境を補完するものであり、場合によっては、それらのモデリング・シミュレーション・ワークロードから得られたデータを活用して、ニューラルネットワーク上で動作する確率モデルを改善することにもつながる。
特別イベント
寄稿者
 西克也
西克也はフェアチャイルド社、クレイ・リサーチ社、ベストシステムズ社など、30年以上に渡ってHPCに関する仕事に従事している。Hpcwire Japanの編集長として記事の作成と翻訳を行っている。
 島田佳代子
1999年~2007年まで英国在住。2001年よりスポーツ、旅、ビジネス、映画など幅広いジャンルで執筆活動を開始し、Hpcwire Japanでは主に日本のHPC業界が世界に誇る研究者、開発者の方々のインタビューを担当。
 小柳義夫
小柳義夫氏は40年以上に亘ってHPCに携わってきた研究者であり、日本のHPC業界における生き字引として有名。現在 高度情報科学技術研究機構に所属し、産業界のHPC推進にあたっている。
 小西史一
小西史一は、理化学研究所、東京工業大学においてHPCおよびバイオインフォマティクスに関する研究と教育に携わってきた研究者。2012年からフォトグラファーとしての活動を開始し、現在はIT技術・セキュリティのコンサルティング業務に携わっている。